Des agents IA qui écrivent les changements de code sur votre vrai dépôt
Les agents AI CodeOps transforment un plan en un vrai diff git sur votre dépôt, écrit dans un clone jetable jamais exécuté, puis testé et relu.
Dans AI CodeOps, l'étape de développement transforme le plan de la session en un vrai changement de code : le nouveau contenu de chaque fichier concerné, écrit dans un clone jetable de votre dépôt et capturé sous la forme d'un diff git. C'est sur ce diff que les tests s'exécutent, c'est lui que lisent les relecteurs, et c'est lui qui arrive sous forme de pull request une fois approuvé.
Le développement se déroule sur la plateforme, dans votre session de navigateur. Il n'y a rien à installer. Le clone est créé avec la connexion git de la personne qui a lancé la session, et il est supprimé une fois le diff extrait. Le code du dépôt n'est jamais exécuté sur les serveurs de la plateforme pendant cette étape. L'exécution du code revient à l'étape de test, qui utilise un bac à sable isolé.
Quels agents interviennent
Les agents d'implémentation décrivent le changement fichier par fichier, avec le code essentiel et les raisons :
- Builder : l'implémenteur généraliste. Il intervient dans Plan, Build, Review & Test, Security-Sensitive Change, UI Implementation, Incident Response, Performance Tuning et Quality-Gated Change.
- Backend Engineer et Frontend Engineer : le travail côté serveur et côté client dans Feature SDLC.
- Database Engineer et Migration Specialist : la conception de schéma et les migrations dans Data Migration, et les mises à niveau dans Dependency Refresh.
- DevOps Engineer : l'étape Apply de DevOps Change.
Ces étapes renvoient du texte. Après la dernière d'entre elles dans le workflow, la session exécute une passe de code distincte. Elle lit la tâche, le contexte du dépôt et ce que l'équipe a écrit jusque-là, et renvoie le nouveau contenu complet de chaque fichier qu'elle modifie. La plateforme écrit ces fichiers dans le clone et en extrait le diff. C'est donc le diff, et non la description du Builder, que vous relisez.
Les étapes qui suivent l'étape d'implémentation, comme Review, Audit diff et Test, ne s'exécutent pas avant la passe de code. Elles s'exécutent une fois le code écrit et vos tests exécutés, et reçoivent le diff et le résultat de test enregistré.
Avec le niveau de modèles Auto, la passe de code va d'abord à un modèle de codage de milieu de gamme (Standard), tandis que les étapes de planification et de revue utilisent le meilleur niveau pour lequel il vous reste du quota. Consultez modèles.
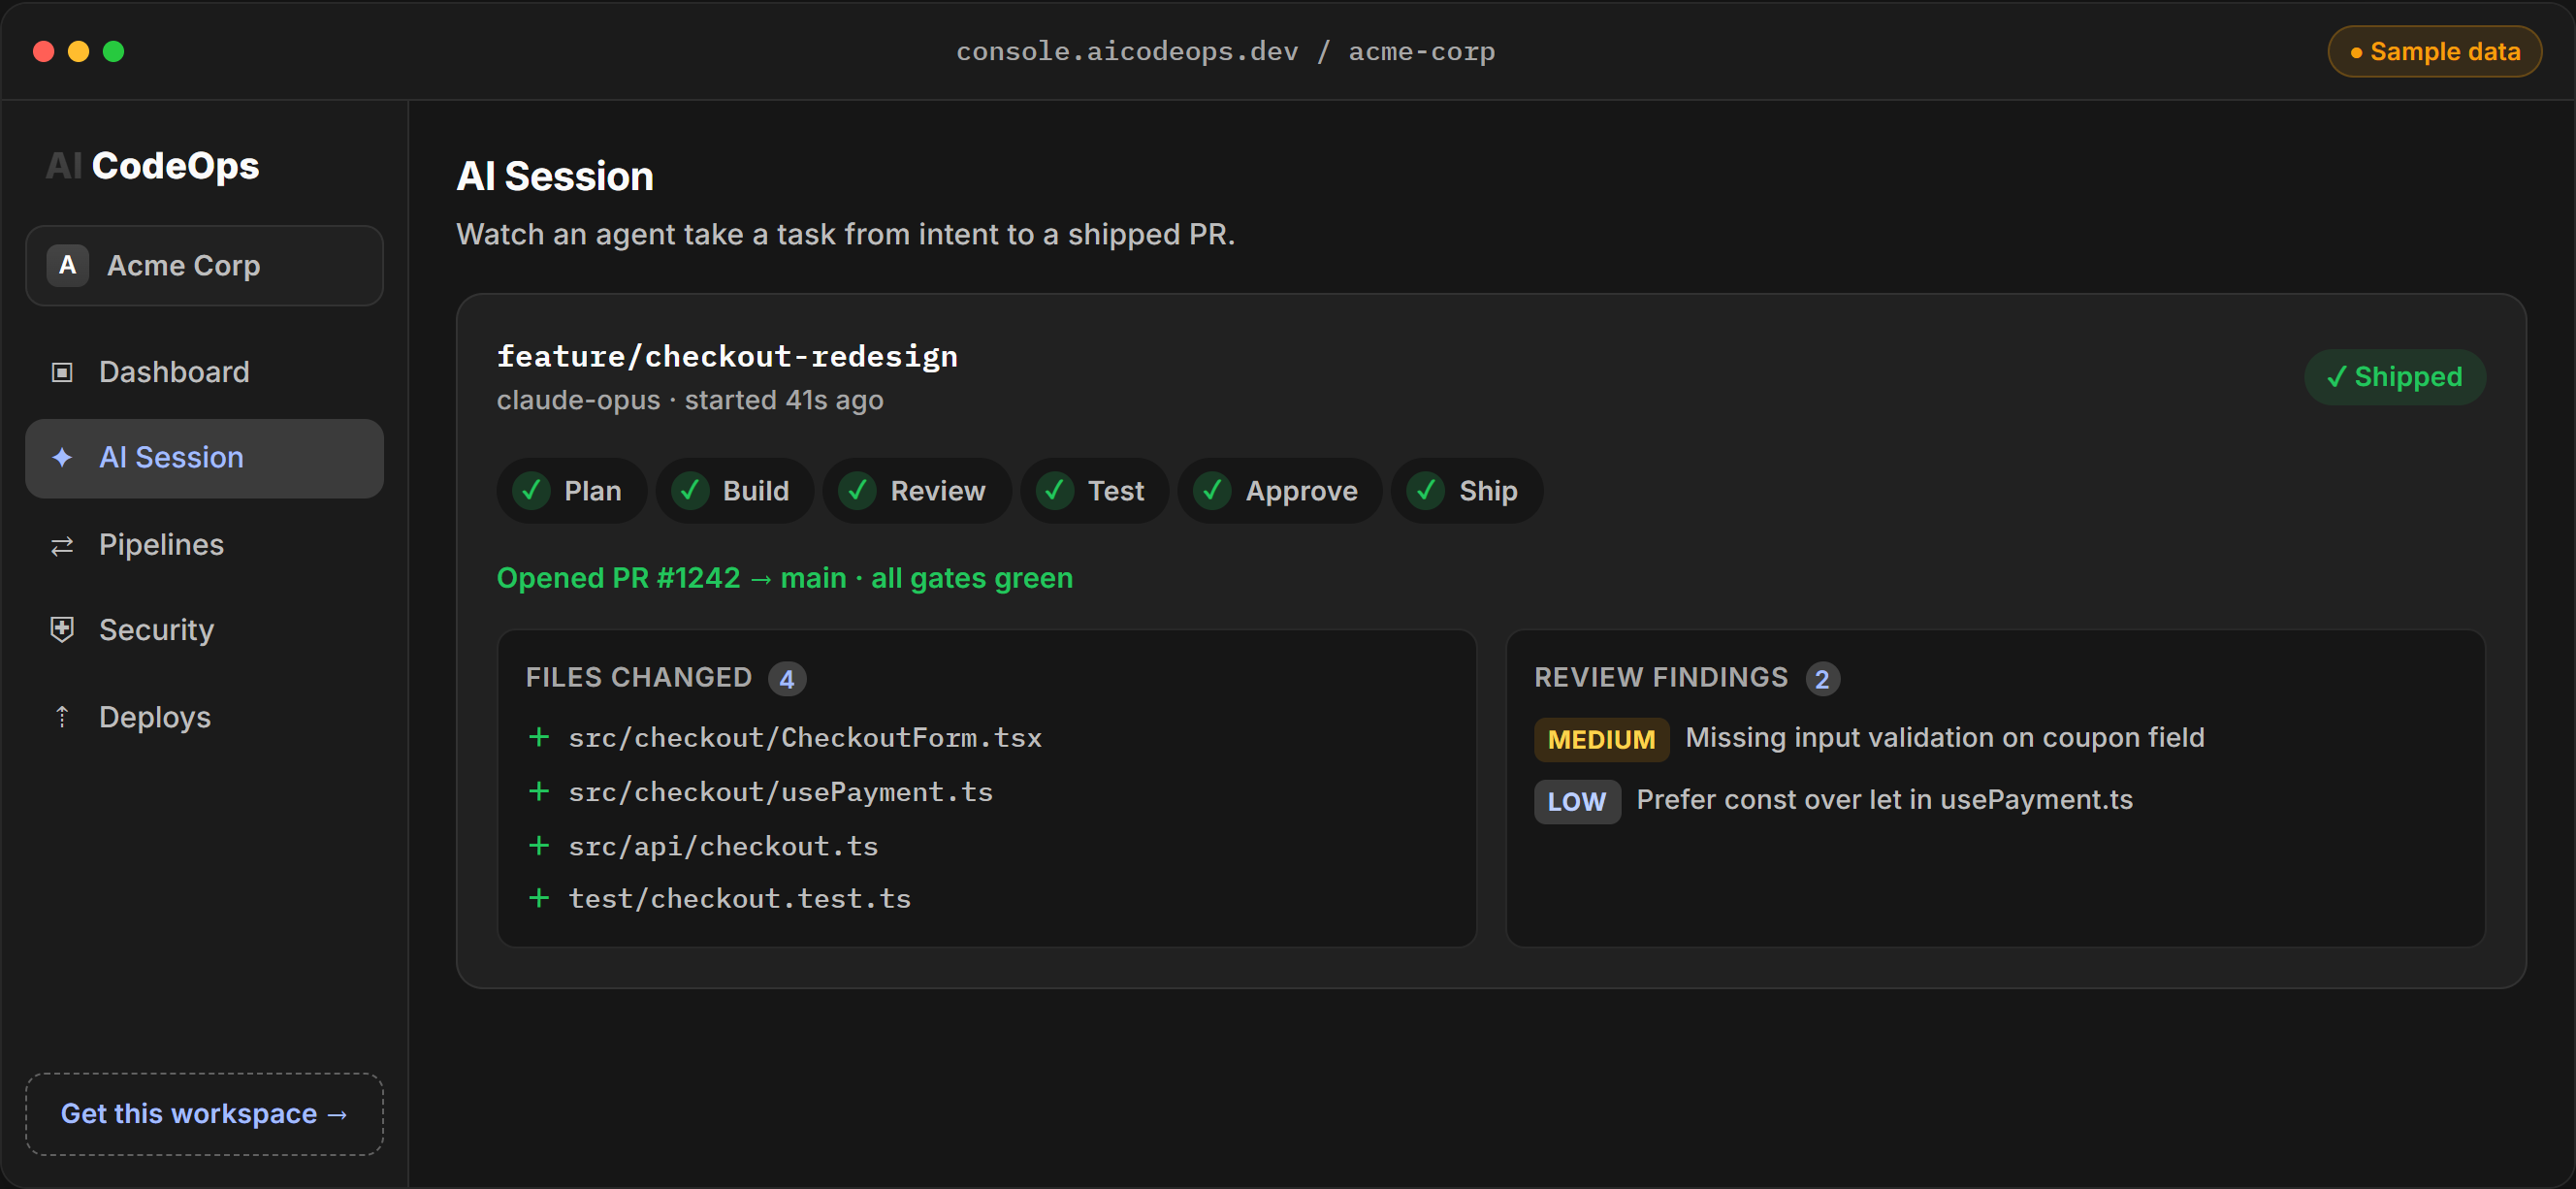
Démo interactive, données d'exemple.
À quoi ressemble un changement
La passe de code doit répondre par un tableau JSON de fichiers entiers. Voici le format que la plateforme demande au modèle et qu'elle analyse :
[
  {
    "path": "src/checkout/CouponField.tsx",
    "content": "import { useState } from \"react\"\n\nexport function CouponField() {\n  ...complete file...\n}\n"
  },
  {
    "path": "test/checkout/coupon-field.test.ts",
    "content": "import { describe, expect, test } from \"vitest\"\n...complete file...\n"
  }
]
Chaque élément est un chemin relatif et le fichier complet après le changement, pas un fragment. La plateforme écrit les fichiers et laisse git calculer le diff, de sorte qu'un fichier modifié apparaît comme un patch normal et un nouveau fichier comme un ajout.
Les projets sans dépôt fonctionnent aussi. Une tâche telle que « créer un petit raccourcisseur d'URL en Python » est alors écrite dans un dépôt git temporaire, et la session produit tout de même un diff téléchargeable. La page Source permet de parcourir ce code, reconstruit à partir du diff.
Travailler avec le changement
- Changes liste chaque changement proposé, son statut et ce qu'il a coûté à produire.
- La page d'une session affiche le diff, les fichiers modifiés et la transcription étape par étape.
- Vous pouvez modifier les fichiers de l'IA dans la console avant l'approbation. Chaque modification est inscrite dans le journal d'audit, et une approbation déjà donnée repasse en attente, car le code n'est plus celui qui a été approuvé.
- Une session de suivi s'appuie sur un changement parent qui n'a pas encore été fusionné. Le diff du parent est appliqué d'abord et montré au modèle, de sorte que « corrige maintenant le bug dans ce que tu as écrit » porte bien sur le code qui a été écrit.
- Un bouton Fix sur un constat lance une nouvelle exécution ciblée sur ce seul problème.
- Un Terminal vous donne un shell dans un bac à sable isolé pour un projet, pour les vérifications que vous voulez lancer vous-même.
Barrières qualité concernées
L'étape de développement a ses propres contrôles avant qu'un humain ne voie le changement :
- La passe de code doit produire des fichiers utilisables. Une réponse tronquée conserve ce qu'elle a écrit et le reste lui est redemandé, jusqu'à cinq fois de plus : la suite du fichier où elle s'est arrêtée, et les fichiers qu'elle n'avait pas atteints. Les marqueurs de diff parasites sont retirés des fichiers, et un fichier qui ne passe pas l'analyse syntaxique est redemandé une fois ; s'il ne la passe toujours pas, il est enregistré comme un constat high. Si l'appel au modèle échoue, si la réponse reste incomplète ou si rien ne peut être lu comme des changements de fichiers, la session se termine en échec avec ce motif. Elle n'apparaît jamais comme terminée sans code.
- Limite de taille. Un diff de plus de 60 Ko environ est refusé en bloc, avec un message invitant à découper la tâche. Il n'est jamais réduit à un fragment qui ne serait relu qu'en partie.
- Budget. La limite de dépenses stricte de l'espace de travail est vérifiée avant la passe de code, comme pour tout autre appel au modèle.
- Politique sur les fichiers. Lorsque le changement est sur le point de devenir une pull request, chaque fichier qu'il modifie est vérifié par rapport à vos règles
diff.apply, et le dépôt par rapport àgithub.push. Une règle peut autoriser, demander une approbation ou refuser, par exemple pour tout ce qui se trouve sousinfra/**. Consultez approbations et politiques.
Après le développement, le changement passe par les tests du projet, puis par les étapes de revue et de test du workflow, puis par une revue des constats sur le diff réel, puis par une personne. Tout cela est résumé sur la page barrières qualité.
Limites
La passe de code lit une quantité fixe de ce que les étapes précédentes ont écrit : lorsque ces étapes sont longues, la dernière peut donc être coupée de ce qu'elle voit. Sa réponse a une taille fixe, si bien que les très gros changements échouent au lieu d'aboutir. Elle traite au maximum 25 fichiers par changement. Gardez des tâches petites, et utilisez des sessions de suivi pour avancer par étapes.
Questions fréquentes
L'IA pousse-t-elle directement sur ma branche principale ?
Non. Le changement reste un diff proposé dans AI CodeOps tant qu'il n'a pas franchi la barrière qualité et qu'une personne ne l'a pas approuvé. AI CodeOps ouvre alors une pull request sur une nouvelle branche.
Sur quels hébergeurs Git peut-il ouvrir des pull requests ?
GitHub, GitLab (sous forme de merge request), Bitbucket, Gitea et Forgejo, via la connexion git de la personne qui a lancé la session. Le changement est placé sur une nouvelle branche nommée codeops/run- suivi de l'identifiant de la session.
Puis-je modifier le code écrit par l'IA avant sa livraison ?
Oui. Vous pouvez modifier, ajouter ou supprimer des fichiers dans le changement d'une session depuis la console. Chaque modification est enregistrée dans le journal d'audit, et toute approbation du changement repasse en attente.
Que se passe-t-il avec un très gros changement ?
Un changement dont le diff dépasse environ 60 Ko est refusé en bloc et la session se termine avec ce motif. Découpez plutôt la tâche en sessions plus petites.
Une deuxième session peut-elle s'appuyer sur le code de la première ?
Oui. Une session de suivi applique d'abord le changement non fusionné de sa session parente, de sorte que son diff contient le changement parent plus le sien.