Agentes de IA que escriben cambios de código sobre tu repositorio real
Los agentes de AI CodeOps convierten un plan en un diff real de tu repositorio, escrito en un clon desechable que nunca se ejecuta, y luego probado y revisado.
En AI CodeOps, la etapa de desarrollo convierte el plan de la sesión en un cambio de código real: el contenido nuevo de cada archivo que toca, escrito en un clon desechable de tu repositorio y capturado como un diff de git. Ese diff es aquello contra lo que se ejecutan las pruebas, lo que leen los revisores y lo que llega como pull request una vez aprobado.
El desarrollo ocurre en la plataforma, en tu sesión del navegador. No hay nada que instalar. El clon se crea con la conexión de git de la persona que inició la sesión y se elimina en cuanto se ha obtenido el diff. Durante este paso, el código del repositorio nunca se ejecuta en los servidores de la plataforma. Ejecutar código es tarea de la etapa de pruebas, que usa un sandbox aislado.
Qué agentes intervienen
Los agentes de implementación describen el cambio archivo por archivo, con el código clave y los motivos:
- Builder: el implementador general. Interviene en Plan, Build, Review & Test, Security-Sensitive Change, UI Implementation, Incident Response, Performance Tuning y Quality-Gated Change.
- Backend Engineer y Frontend Engineer: el trabajo del lado del servidor y del lado del cliente en Feature SDLC.
- Database Engineer y Migration Specialist: el diseño de esquemas y las migraciones en Data Migration, y las actualizaciones en Dependency Refresh.
- DevOps Engineer: el paso Apply de DevOps Change.
Estos pasos devuelven texto. Después del último de ellos en el flujo de trabajo, la sesión ejecuta una pasada de código aparte. Lee la tarea, el contexto del repositorio y lo que el equipo ha escrito hasta ese momento, y devuelve el contenido nuevo y completo de cada archivo que cambia. La plataforma escribe esos archivos en el clon y obtiene el diff. Así que lo que revisas es el diff, no la descripción del Builder.
Los pasos que vienen después del paso de implementación, como Review, Audit diff y Test, no se ejecutan antes de la pasada de código. Se ejecutan cuando el código ya está escrito y tus pruebas ya se han ejecutado, y se les muestra el diff y el resultado de pruebas registrado.
Con el nivel de modelo Auto, la pasada de código va primero a un modelo de programación de gama media (Standard), mientras que los pasos de planificación y de revisión usan el mejor nivel para el que tengas cuota. Consulta modelos.
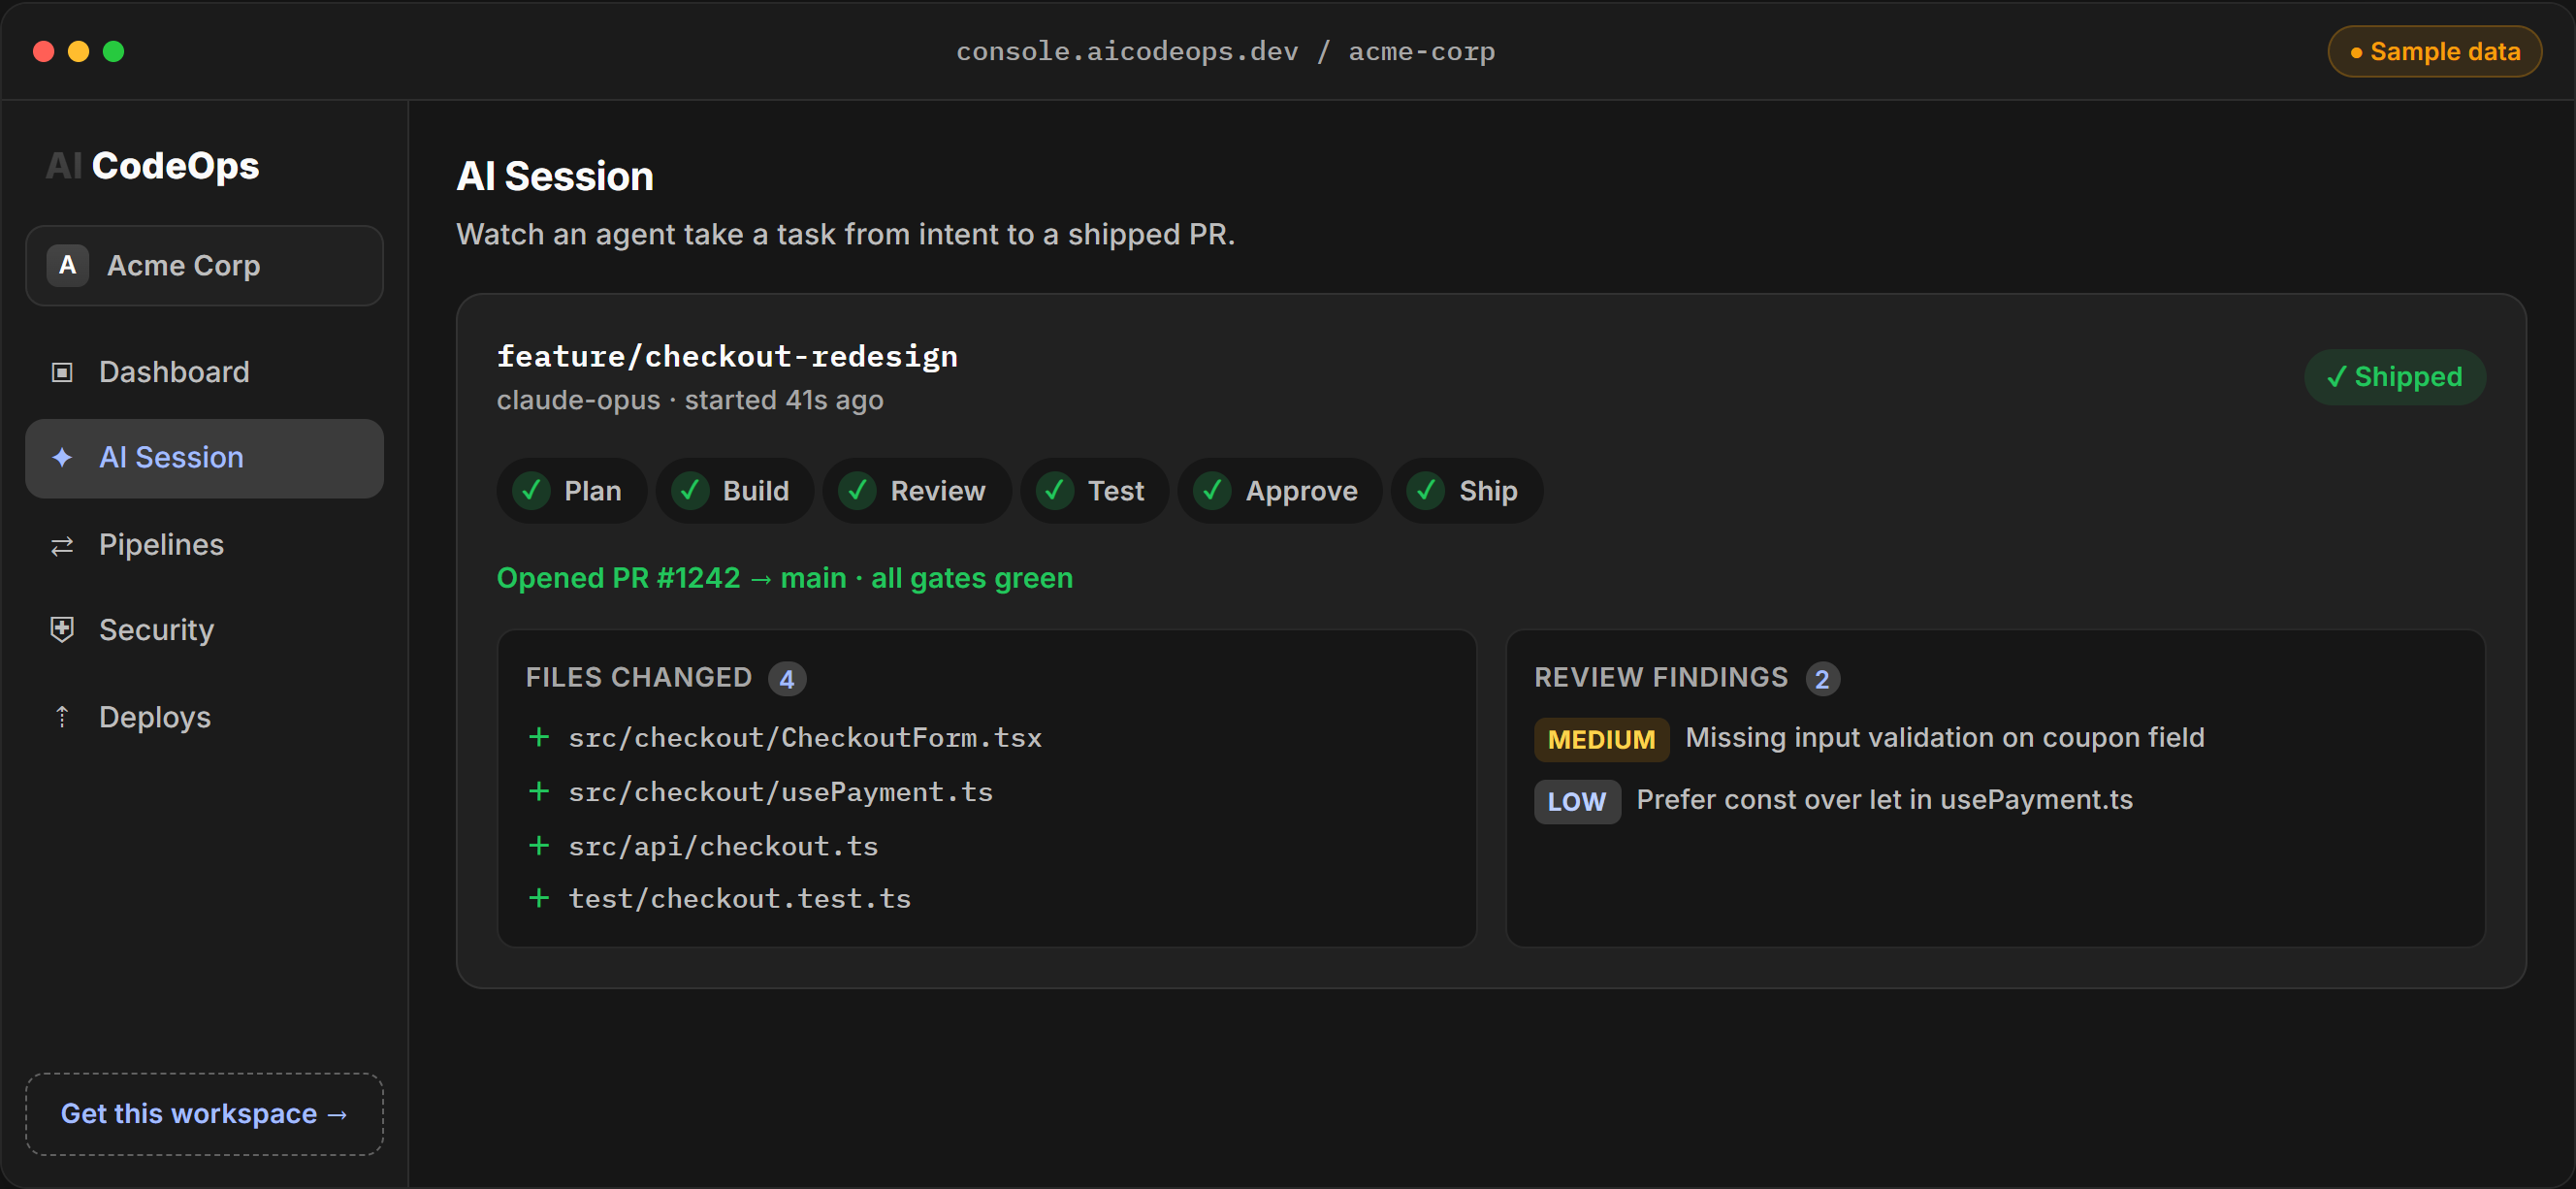
Demo interactiva, datos de ejemplo.
Qué aspecto tiene un cambio
La pasada de código debe responder con un array JSON de archivos completos. Este es el formato que la plataforma pide al modelo y que analiza:
[
  {
    "path": "src/checkout/CouponField.tsx",
    "content": "import { useState } from \"react\"\n\nexport function CouponField() {\n  ...complete file...\n}\n"
  },
  {
    "path": "test/checkout/coupon-field.test.ts",
    "content": "import { describe, expect, test } from \"vitest\"\n...complete file...\n"
  }
]
Cada elemento es una ruta relativa y el archivo completo después del cambio, no un fragmento. La plataforma escribe los archivos y deja que git calcule el diff, de modo que un archivo modificado aparece como un parche normal y un archivo nuevo como una adición.
Los proyectos sin repositorio también funcionan. Una tarea como «crea un pequeño acortador de URL en Python» se escribe en un repositorio git temporal, y la sesión produce igualmente un diff descargable. La página Source permite explorar ese código, reconstruido a partir del diff.
Trabajar con el cambio
- Changes lista cada cambio propuesto, su estado y lo que costó producirlo.
- La página de una sesión muestra el diff, los archivos modificados y la transcripción paso a paso.
- Puedes editar los archivos de la IA en la consola antes de la aprobación. Cada edición se anota en el registro de auditoría, y una aprobación ya concedida vuelve a pendiente, porque el código ya no es el que se aprobó.
- Una sesión de seguimiento se basa en un cambio padre que todavía no se ha fusionado. El diff del padre se aplica primero y se muestra al modelo, de modo que «ahora corrige el error en lo que escribiste» trabaja sobre el código que se escribió.
- Un botón Fix en un hallazgo inicia una ejecución nueva dirigida a ese único problema.
- Un Terminal te da una shell en un sandbox aislado para un proyecto, para las comprobaciones que quieras ejecutar por tu cuenta.
Controles de calidad implicados
La etapa de desarrollo tiene sus propias comprobaciones antes de que ninguna persona vea el cambio:
- La pasada de código debe producir archivos utilizables. Una respuesta que se corta conserva lo que escribió y se le pide el resto, hasta cinco veces más: lo que faltaba del archivo en el que se detuvo y los archivos a los que no había llegado. Los marcadores de diff sueltos se quitan de los archivos, y un archivo que no se puede analizar se pide una vez más; si sigue sin poder analizarse, se registra como un hallazgo de gravedad high. Si la llamada al modelo falla, la respuesta sigue incompleta o nada se puede interpretar como cambios de archivos, la sesión termina como fallida con ese motivo. Nunca aparece como completada sin código.
- Límite de tamaño. Un diff de más de unos 60 KB se rechaza entero, con un mensaje que pide dividir la tarea. Nunca se recorta a un fragmento que se revisaría solo en parte.
- Presupuesto. El límite de gasto estricto del espacio de trabajo se comprueba antes de la pasada de código, como en cualquier otra llamada al modelo.
- Política sobre archivos. Cuando el cambio está a punto de convertirse en un pull request, cada archivo que cambia se comprueba con tus reglas
diff.apply, y el repositorio congithub.push. Una regla puede permitir, pedir una aprobación o denegar, por ejemplo para cualquier cosa bajoinfra/**. Consulta aprobaciones y políticas.
Después del desarrollo, el cambio pasa por las pruebas del proyecto, luego por los pasos de revisión y de pruebas del flujo de trabajo, luego por una revisión de hallazgos del diff real y, por último, por una persona. Todo ello se resume en la página de controles de calidad.
Límites
La pasada de código lee una cantidad fija de lo que escribieron los pasos anteriores, así que cuando esos pasos son largos, el último de ellos puede quedar recortado en lo que ve. Su respuesta tiene un tamaño fijo, así que los cambios muy grandes fallan en lugar de llegar a aplicarse. Maneja como máximo 25 archivos en un cambio. Mantén las tareas pequeñas y usa sesiones de seguimiento para desarrollar por pasos.
Preguntas frecuentes
¿La IA hace push directamente a mi rama principal?
No. El cambio sigue siendo un diff propuesto dentro de AI CodeOps hasta que supera el control de calidad y una persona lo aprueba. Entonces AI CodeOps abre un pull request en una rama nueva.
¿En qué proveedores de Git puede abrir pull requests?
GitHub, GitLab (como merge request), Bitbucket, Gitea y Forgejo, mediante la conexión de git de la persona que inició la sesión. El cambio va en una rama nueva llamada codeops/run- seguido del ID de la sesión.
¿Puedo editar el código que escribió la IA antes de que se entregue?
Sí. Puedes editar, añadir o eliminar archivos del cambio de una sesión desde la consola. Cada edición queda anotada en el registro de auditoría, y cualquier aprobación del cambio vuelve a pendiente.
¿Qué pasa con un cambio muy grande?
Un cambio cuyo diff supera unos 60 KB se rechaza entero y la sesión termina con ese motivo. Divide la tarea en sesiones más pequeñas.
¿Puede una segunda sesión basarse en el código de la primera?
Sí. Una sesión de seguimiento aplica primero el cambio aún sin fusionar de su sesión padre, de modo que su diff contiene el cambio de la sesión padre más el suyo.